
Все запросы sql. Основы SQL для начинающих с уроками
Лабораторная работа № 2
Тема : Простые запросы на выборку данных средствами SQL .
Цель работы : Изучить синтаксис инструкции SQL SELECT , для создания простых запросов на выборку данных. Используя предложения WHERE задать условия отбора строк из таблиц определенных в предложении FROM . Изучить организацию выборки данных из нескольких таблиц БД.
1. Выборка данных.
Для извлечения записей из таблиц в SQL определен оператор SELECT . С помощью этой команды осуществляется не только операция реляционной алгебры "выборка" (селекция), но и предварительное соединение (join) двух и более таблиц. Это наиболее сложное и мощное средство SQL, полный синтаксис оператора SELECT имеет вид:
SELECT < список _ выбора >
FROM <имя_таблицы>, ...
[ WHERE <условие> ]
[ GROUP BY <имя_столбца>,... ]
[ HAVING < условие > ]
,... ]
Все примеры, приведенные ниже, касающиеся базы данных publications используют пример лабораторной работы № 1 (lab _1_ CREATE _ TABLE . htm ) поэтому результаты запросов на создание таблиц здесь не приводятся.
Порядок предложений в операторе SELECT должен строго соблюдаться (например, GROUP BY должно всегда предшествовать ORDER BY ), иначе это приведет к появлению ошибок.
Этот оператор всегда начинается с ключевого слова SELECT . В конструкции <список_выбора> определяется столбец или столбцы, включаемые в результат. Он может состоять из имен одного или нескольких столбцов, или из одного символа «*» (звездочка), определяющего все столбцы. Элементы списка разделяются запятыми.
SELECT author FROM authors ;
получить список всех полей таблицы authors :
SELECT * FROM authors ;
В том случае, когда нас интересуют не все записи, а только те, которые удовлетворяют некому условию, это условие можно указать после ключевого слова WHERE . Например, найдем все книги, опубликованные после 1996 года:
SELECT title FROM titles WHERE yearpub > 1996;
Допустим теперь, что надо найти все публикации за интервал 1995 - 1997 гг. Это условие можно записать в виде :
SELECT title FROM titles WHERE yearpub>=1995 AND yearpub<=1997;
В заключение заметим, что при выполнении оператора SELECT результирующее отношение может иметь несколько записей с одинаковыми значениями всех полей. Чтобы исключить повторяющиеся записи из выборки используется ключевое слово DISTINCT . Ключевое слово ALL указывает, что в результат необходимо включать все строки.
2. Выборка из нескольких таблиц.
Очень часто возникает ситуация, когда выборку данных надо производить из отношения, которое является результатом слияния двух других отношений. Например, нужно получить из базы данных publications информацию обо всех печатных изданиях в виде следующей таблицы:
|
title |
yearpub |
publisher |
Для этого СУБД предварительно должна выполнить слияние таблиц titles и publishers , и только затем произвести выборку из полученного отношения.
Для выполнения операции такого рода в операторе SELECT после ключевого слова FROM указывается список таблиц, по которым производится поиск данных. После ключевого слова WHERE указывается условие, по которому производится слияние. Для того, чтобы выполнить данный запрос, нужно дать команду:
SELECT titles . title , titles . yearpub , publishers . publisher
FROM titles,publishers
WHERE titles.pub_id=publishers.pub_id;
Пример, где одновременно задаются условия и слияния, и выборки (результат предыдущего запроса ограничивается изданиями после 1996 года):
SELECT titles.title,titles.yearpub,publishers.publisher
FROM titles,publishers
WHERE titles.pub_id=publishers.pub_id AND
titles.yearpub>1996;
Следует обратить внимание на то, что когда в разных таблицах присутствуют одноименные поля, то для устранения неоднозначности перед именем поля указывается имя таблицы и знак "." (точка). (Рекомендуется имя таблицы указывать всегда! )
Естественно, имеется возможность производить слияние и более чем двух таблиц. Например, чтобы дополнить описанную выше выборку именами авторов книг необходимо составить оператор следующего вида:
Publishers.publisher
FROM titles,publishers,titleauthors,authors
WHERE titleauthors.au_id=authors.au_id AND
Titleauthors.title_id=titles.title_id AND
Titles.pub_id=publishers.pub_id AND
Titles . yearpub > 1996;
Альтернативный вариант слияния нескольких таблиц может использовать оператор
соединения таблиц непосредственно в предложении FROM . Существует три
варианта оператора:
INNER JOIN соединение, при котором записи включаются в результирующий
набор только в том случае, если в связных атрибутах будут найдены одинаковые
значения;
LEFT JOIN левое соединение, при котором все записи из первой (левой)
таблицы включаются в результирующий набор, даже если во второй (правой)
таблице нет соответствующих им записей;
RIGHT JOIN правое соединение, при котором все записи из второй (правой)
таблицы включаются в результирующий набор, даже если в первой (левой) таблице
нет соответствующих им записей.
Например, предыдущий пример можно реализовать с использованием оператора
INNER JOIN следующим образом :
SELECT authors.author,titles.title,titles.yearpub,
Publishers.publisher
FROM ((titles INNER JOIN publishers ON
Titles.pub_id=publishers.pub_id)
INNER JOIN titleauthors ON
Itleauthors.title_id=titles.title_id)
INNER JOIN authors ON
Titleauthors.au_id=authors.au_id
WHERE titles.yearpub > 1996;
3. Вычисления внутри SELECT.
SQL позволяет выполнять различные арифметические операции над столбцами результирующего отношения. В конструкции <список_выбора> можно использовать константы, функции и их комбинации с арифметическими операциями и скобками. Например, чтобы узнать, сколько лет прошло с 1992 года (год принятия стандарта SQL-92) до публикации той или иной книги можно выполнить команду:
SELECT title, yearpub-1992 FROM titles WHERE yearpub > 1992;
В арифметических выражениях допускаются операции сложения (+), вычитания (-),
деления (/), умножения (*), а также различные функции (COS, SIN, ABS
абсолютное значение и т.д.).
В SQL также определены так называемые агрегатные функции, которые совершают действия над совокупностью одинаковых полей в группе записей. Среди них:
AVG(<имя поля>) - среднее по всем значениям данного поля
COUNT(<имя поля>) или COUNT (*) - число записей
MAX(<имя поля>) - максимальное из всех значений данного поля
MIN(<имя поля>) - минимальное из всех значений данного поля
SUM(<имя поля>) - сумма всех значений данного поля
Следует учитывать, что каждая агрегирующая функция возвращает единственное значение.
Примеры: определить дату публикации самой "древней" книги в нашей базе данных
SELECT MIN(yearpub) FROM titles;
SELECT COUNT (*) FROM titles ;
Область действия данных функции можно ограничить с помощью логического условия. Например, количество книг, выпущенных после 2000 года:
SELECT COUNT (*) FROM titles WHERE yearpub > 2000;
4. Функции для работы с датой
В MS Access предусмотрен целый набор встроенных функций дат и времени Перечислим некоторые из них:
Date () - текущая дата, т е сегодняшнее число, месяц и год;
D ау(дата) - извлекает из даты день, например дата - 12,09,97, число 12;
Мо nth (дата) - извлекает из даты месяц, например дата - 12,09,97, результат применения функции - число 9;
Уеаг(дата) - извлекает из даты год, например дата - 12-09,97, результат применения функции - число 97;
Weekday (дата) - извлекает из даты день недели в американской системе нумерации дней, а именно в примере - дата 12,09,97, результат применения функции - число 6, что соответствует пятнице,
DatePart (HHTepBan , дата) - здесь аргумент "интервал" - это сокращенное название нужного компонента даты, а дата - конкретное значение даты или имя поля с датой
Например:
DatePart (" H ",#12,09,97#) - день недели - 6, т е пятница,
DatePart (" HH ",#12,09,97#) - неделя года - 37,
DatePart (" K ",# 12,09,97#) - квартал года - 3
DatePart("a",#12,09,97#) - день -12,
DatePart("M",#12,09,97#) - месяц - 9, \ DatePart("rrrr",#12,09,97#) - год -1997
Пример запроса. Определить, сколько лет прошло с момента выхода статьи описавшей стандарт SQL (предположим, что название статьи ”Стандарт SQL ”)
SELECT Month(Date()-yearpub)
FROM titles INNER JOIN publishers ON
titles.pub_id = publishers.pub_id
WHERE publisher = "Стандарт SQL ";
5. Задание к лабораторной работе
Замечания по ходу выполнения лабораторной работы.
Для просмотра результата выполнения запросов необходимо чтобы в таблицах были внесены данные соответствующими сформулированным запросам. При этом данные в запросах (даты, фамилии, количество и т.п.) могут быть изменены по факту внесенных данных в БД.
При выполнении заданий лабораторной работы все вычисляемые поля заменять синонимами, используя опцию AS в предложении SELECT .
Например : SELECT COUNT (*) AS Количество _ строк FROM titles ;
Реализовать следующие запросы средствами SQL :
Найти заказы сделанные в январе.
Найти изделия, которые поставляются в количестве не меньше 10 , и не больше 100 .
Получить список изделий получаемых заказчиком “з-д «Красный луч»”, цена которых более 50 тыс. грн.
Сколько деталей «Болт» по всем заказам получил заказчик “з-д «Красный луч»”.
Определить наименования деталей заказанных в период с 6/10/ 97 по 10/10/97, которые не заказывал з-д «Красный луч».
Получить список наименований изделий, поставки которых превышают 10 тыс.
На какую сумму заказано деталей з-дом «Красный луч»
Какие заказчики заказывали деталь «Болт».
Определить среднее количество поставок детали «Болт» за 1997 год.
Найти заказчика, заказавшего самую дорогую деталь.
6. Контрольные вопросы
Какие предложения SELECT являются обязательными?
Что задает предложение WHERE?
Какие типы соединений ( JOIN ) поддерживает инструкция SELECT ?
Какая последовательность предложений инструкции SELECT ?
В каком случае обязательно указывать имя таблицы перед именем поля?
Как формировать вычисляемые поля в SELECT ?
Можно ли соединять более двух таблиц операцией JOIN ?
Какой альтернативный синтаксис операции JOIN (с использованием WHERE ) можно использовать для корректного выполнения запроса?
- Перевод
- Tutorial
Надо “ SELECT * WHERE a=b FROM c ” или “ SELECT WHERE a=b FROM c ON * ” ?
Если вы похожи на меня, то согласитесь: SQL - это одна из тех штук, которые на первый взгляд кажутся легкими (читается как будто по-английски!), но почему-то приходится гуглить каждый простой запрос, чтобы найти правильный синтаксис.
А потом начинаются джойны, агрегирование, подзапросы, и получается совсем белиберда. Вроде такой:
SELECT members.firstname || " " || members.lastname AS "Full Name" FROM borrowings INNER JOIN members ON members.memberid=borrowings.memberid INNER JOIN books ON books.bookid=borrowings.bookid WHERE borrowings.bookid IN (SELECT bookid FROM books WHERE stock>(SELECT avg(stock) FROM books)) GROUP BY members.firstname, members.lastname;
Буэ! Такое спугнет любого новичка, или даже разработчика среднего уровня, если он видит SQL впервые. Но не все так плохо.
Легко запомнить то, что интуитивно понятно, и с помощью этого руководства я надеюсь снизить порог входа в SQL для новичков, а уже опытным предложить по-новому взглянуть на SQL.
Не смотря на то, что синтаксис SQL почти не отличается в разных базах данных, в этой статье для запросов используется PostgreSQL. Некоторые примеры будут работать в MySQL и других базах.
1. Три волшебных слова
В SQL много ключевых слов, но SELECT , FROM и WHERE присутствуют практически в каждом запросе. Чуть позже вы поймете, что эти три слова представляют собой самые фундаментальные аспекты построения запросов к базе, а другие, более сложные запросы, являются всего лишь надстройками над ними.
2. Наша база
Давайте взглянем на базу данных, которую мы будем использовать в качестве примера в этой статье:


У нас есть книжная библиотека и люди. Также есть специальная таблица для учета выданных книг.
- В таблице "books" хранится информация о заголовке, авторе, дате публикации и наличии книги. Все просто.
- В таблице “members” - имена и фамилии всех записавшихся в библиотеку людей.
- В таблице “borrowings” хранится информация о взятых из библиотеки книгах. Колонка bookid относится к идентификатору взятой книги в таблице “books”, а колонка memberid относится к соответствующему человеку из таблицы “members”. У нас также есть дата выдачи и дата, когда книгу нужно вернуть.
3. Простой запрос
Давайте начнем с простого запроса: нам нужны имена и идентификаторы (id) всех книг, написанных автором “Dan Brown”
Запрос будет таким:
SELECT bookid AS "id", title FROM books WHERE author="Dan Brown";
А результат таким:
| id | title |
|---|---|
| 2 | The Lost Symbol |
| 4 | Inferno |
Довольно просто. Давайте разберем запрос чтобы понять, что происходит.
3.1 FROM - откуда берем данные
Сейчас это может показаться очевидным, но FROM будет очень важен позже, когда мы перейдем к соединениям и подзапросам.
FROM указывает на таблицу, по которой нужно делать запрос. Это может быть уже существующая таблица (как в примере выше), или таблица, создаваемая на лету через соединения или подзапросы.
3.2 WHERE - какие данные показываем
WHERE просто-напросто ведет себя как фильтр строк , которые мы хотим вывести. В нашем случае мы хотим видеть только те строки, где значение в колонке author - это “Dan Brown”.
3.3 SELECT - как показываем данные
Теперь, когда у нас есть все нужные нам колонки из нужной нам таблицы, нужно решить, как именно показывать эти данные. В нашем случае нужны только названия и идентификаторы книг, так что именно это мы и выберем с помощью SELECT . Заодно можно переименовать колонку используя AS .
Весь запрос можно визуализировать с помощью простой диаграммы:

4. Соединения (джойны)
Теперь мы хотим увидеть названия (не обязательно уникальные) всех книг Дэна Брауна, которые были взяты из библиотеки, и когда эти книги нужно вернуть:
SELECT books.title AS "Title", borrowings.returndate AS "Return Date" FROM borrowings JOIN books ON borrowings.bookid=books.bookid WHERE books.author="Dan Brown";
Результат:
| Title | Return Date |
|---|---|
| The Lost Symbol | 2016-03-23 00:00:00 |
| Inferno | 2016-04-13 00:00:00 |
| The Lost Symbol | 2016-04-19 00:00:00 |
По большей части запрос похож на предыдущий за исключением секции FROM . Это означает, что мы запрашиваем данные из другой таблицы . Мы не обращаемся ни к таблице “books”, ни к таблице “borrowings”. Вместо этого мы обращаемся к новой таблице , которая создалась соединением этих двух таблиц.
borrowings JOIN books ON borrowings.bookid=books.bookid - это, считай, новая таблица, которая была сформирована комбинированием всех записей из таблиц "books" и "borrowings", в которых значения bookid совпадают. Результатом такого слияния будет:

А потом мы делаем запрос к этой таблице так же, как в примере выше. Это значит, что при соединении таблиц нужно заботиться только о том, как провести это соединение. А потом запрос становится таким же понятным, как в случае с «простым запросом» из пункта 3.
Давайте попробуем чуть более сложное соединение с двумя таблицами.
Теперь мы хотим получить имена и фамилии людей, которые взяли из библиотеки книги автора “Dan Brown”.
На этот раз давайте пойдем снизу вверх:
Шаг Step 1 - откуда берем данные? Чтобы получить нужный нам результат, нужно соединить таблицы “member” и “books” с таблицей “borrowings”. Секция JOIN будет выглядеть так:
borrowings JOIN books ON borrowings.bookid=books.bookid JOIN members ON members.memberid=borrowings.memberid
Результат соединения можно увидеть по ссылке .
Шаг 2 - какие данные показываем? Нас интересуют только те данные, где автор книги - “Dan Brown”
WHERE books.author="Dan Brown"
Шаг 3 - как показываем данные? Теперь, когда данные получены, нужно просто вывести имя и фамилию тех, кто взял книги:
SELECT members.firstname AS "First Name", members.lastname AS "Last Name"
Супер! Осталось лишь объединить три составные части и сделать нужный нам запрос:
SELECT members.firstname AS "First Name", members.lastname AS "Last Name" FROM borrowings JOIN books ON borrowings.bookid=books.bookid JOIN members ON members.memberid=borrowings.memberid WHERE books.author="Dan Brown";
Что даст нам:
| First Name | Last Name |
|---|---|
| Mike | Willis |
| Ellen | Horton |
| Ellen | Horton |
Отлично! Но имена повторяются (они не уникальны). Мы скоро это исправим.
5. Агрегирование
Грубо говоря, агрегирования нужны для конвертации нескольких строк в одну . При этом, во время агрегирования для разных колонок используется разная логика.
Давайте продолжим наш пример, в котором появляются повторяющиеся имена. Видно, что Ellen Horton взяла больше одной книги, но это не самый лучший способ показать эту информацию. Можно сделать другой запрос:
SELECT members.firstname AS "First Name", members.lastname AS "Last Name", count(*) AS "Number of books borrowed" FROM borrowings JOIN books ON borrowings.bookid=books.bookid JOIN members ON members.memberid=borrowings.memberid WHERE books.author="Dan Brown" GROUP BY members.firstname, members.lastname;
Что даст нам нужный результат:
| First Name | Last Name | Number of books borrowed |
|---|---|---|
| Mike | Willis | 1 |
| Ellen | Horton | 2 |
Почти все агрегации идут вместе с выражением GROUP BY . Эта штука превращает таблицу, которую можно было бы получить запросом, в группы таблиц. Каждая группа соответствует уникальному значению (или группе значений) колонки, которую мы указали в GROUP BY . В нашем примере мы конвертируем результат из прошлого упражнения в группу строк. Мы также проводим агрегирование с count , которая конвертирует несколько строк в целое значение (в нашем случае это количество строк). Потом это значение приписывается каждой группе.
Каждая строка в результате представляет собой результат агрегирования каждой группы.
Можно прийти к логическому выводу, что все поля в результате должны быть или указаны в GROUP BY , или по ним должно производиться агрегирование. Потому что все другие поля могут отличаться друг от друга в разных строках, и если выбирать их SELECT "ом, то непонятно, какие из возможных значений нужно брать.
В примере выше функция count обрабатывала все строки (так как мы считали количество строк). Другие функции вроде sum или max обрабатывают только указанные строки. Например, если мы хотим узнать количество книг, написанных каждым автором, то нужен такой запрос:
SELECT author, sum(stock) FROM books GROUP BY author;
Результат:
| author | sum |
|---|---|
| Robin Sharma | 4 |
| Dan Brown | 6 |
| John Green | 3 |
| Amish Tripathi | 2 |
Здесь функция sum обрабатывает только колонку stock и считает сумму всех значений в каждой группе.
6. Подзапросы

Подзапросы это обычные SQL-запросы, встроенные в более крупные запросы. Они делятся на три вида по типу возвращаемого результата.
6.1 Двумерная таблица
Есть запросы, которые возвращают несколько колонок. Хороший пример это запрос из прошлого упражнения по агрегированию. Будучи подзапросом, он просто вернет еще одну таблицу, по которой можно делать новые запросы. Продолжая предыдущее упражнение, если мы хотим узнать количество книг, написанных автором “Robin Sharma”, то один из возможных способов - использовать подзапросы:
SELECT * FROM (SELECT author, sum(stock) FROM books GROUP BY author) AS results WHERE author="Robin Sharma";
Результат:
Можно записать как: ["Robin Sharma", "Dan Brown"]
2. Теперь используем этот результат в новом запросе:
SELECT title, bookid FROM books WHERE author IN (SELECT author FROM (SELECT author, sum(stock) FROM books GROUP BY author) AS results WHERE sum > 3);
Результат:
| title | bookid |
|---|---|
| The Lost Symbol | 2 |
| Who Will Cry When You Die? | 3 |
| Inferno | 4 |
Это то же самое, что:
SELECT title, bookid FROM books WHERE author IN ("Robin Sharma", "Dan Brown");
6.3 Отдельные значения
Бывают запросы, результатом которых являются всего одна строка и одна колонка. К ним можно относиться как к константным значениям, и их можно использовать везде, где используются значения, например, в операторах сравнения. Их также можно использовать в качестве двумерных таблиц или массивов, состоящих из одного элемента.
Давайте, к примеру, получим информацию о всех книгах, количество которых в библиотеке превышает среднее значение в данный момент.
Среднее количество можно получить таким образом:
select avg(stock) from books;
Что дает нам:
7. Операции записи
Большинство операций записи в базе данных довольно просты, если сравнивать с более сложными операциями чтения.
7.1 Update
Синтаксис запроса UPDATE семантически совпадает с запросом на чтение. Единственное отличие в том, что вместо выбора колонок SELECT "ом, мы задаем знаения SET "ом.
Если все книги Дэна Брауна потерялись, то нужно обнулить значение количества. Запрос для этого будет таким:
UPDATE books SET stock=0 WHERE author="Dan Brown";
WHERE делает то же самое, что раньше: выбирает строки. Вместо SELECT , который использовался при чтении, мы теперь используем SET . Однако, теперь нужно указать не только имя колонки, но и новое значение для этой колонки в выбранных строках.
7.2 Delete
Запрос DELETE это просто запрос SELECT или UPDATE без названий колонок. Серьезно. Как и в случае с SELECT и UPDATE , блок WHERE остается таким же: он выбирает строки, которые нужно удалить. Операция удаления уничтожает всю строку, так что не имеет смысла указывать отдельные колонки. Так что, если мы решим не обнулять количество книг Дэна Брауна, а вообще удалить все записи, то можно сделать такой запрос:
DELETE FROM books WHERE author="Dan Brown";
7.3 Insert
Пожалуй, единственное, что отличается от других типов запросов, это INSERT . Формат такой:
INSERT INTO x (a,b,c) VALUES (x, y, z);
Где a , b , c это названия колонок, а x , y и z это значения, которые нужно вставить в эти колонки, в том же порядке. Вот, в принципе, и все.
Взглянем на конкретный пример. Вот запрос с INSERT , который заполняет всю таблицу "books":
INSERT INTO books (bookid,title,author,published,stock) VALUES (1,"Scion of Ikshvaku","Amish Tripathi","06-22-2015",2), (2,"The Lost Symbol","Dan Brown","07-22-2010",3), (3,"Who Will Cry When You Die?","Robin Sharma","06-15-2006",4), (4,"Inferno","Dan Brown","05-05-2014",3), (5,"The Fault in our Stars","John Green","01-03-2015",3);
8. Проверка
Мы подошли к концу, предлагаю небольшой тест. Посмотрите на тот запрос в самом начале статьи. Можете разобраться в нем? Попробуйте разбить его на секции SELECT , FROM , WHERE , GROUP BY , и рассмотреть отдельные компоненты подзапросов.
Вот он в более удобном для чтения виде:
SELECT members.firstname || " " || members.lastname AS "Full Name" FROM borrowings INNER JOIN members ON members.memberid=borrowings.memberid INNER JOIN books ON books.bookid=borrowings.bookid WHERE borrowings.bookid IN (SELECT bookid FROM books WHERE stock> (SELECT avg(stock) FROM books)) GROUP BY members.firstname, members.lastname;
Этот запрос выводит список людей, которые взяли из библиотеки книгу, у которой общее количество выше среднего значения.
Результат:
| Full Name |
|---|
| Lida Tyler |
Надеюсь, вам удалось разобраться без проблем. Но если нет, то буду рад вашим комментариям и отзывам, чтобы я мог улучшить этот пост.
Теги: Добавить метки
В рамках данной статьи, я расскажу вам самые азы баз данных и приведу примеры sql-запросов для начинающих .
Когда человек впервые начинает читать обзоры про базы данных, то его голова просто разрывается от огромной массы технических терминов. Все эти первичные и вторичные ключи, таблицы, связи, процедуры, представления, индексы, условия, подзапросы, колонки, типы данных и прочее. И все это "как бы" необходимо учитывать. Как говорится, "А-а-а-а-а".
Однако, в этом и состоит одна из самых больших ошибок - читать термины, а не понимать их суть . Поэтому, многие из таких любознательных и нетерпеливых либо бросают это дело, либо вскользь осваивают материал и потом пишут невесть что. Изучать базу данных нужно с самого простого - с основы. И уже только затем остальные возможности.
Прочитав этот обзор, вы усами убедитесь, что никаких сверх сложных тайн в базах данных нет, сложности лишь касаются отдельных технических аспектов, позволяющих, к примеру, оптимизировать скорость и потребляемую оперативную память.
Примечание : Материал предназначен для начинающих, но часть вещей может быть полезна и остальным.
Основа любой базы данных - таблицы и 4 типа запросов
Основой любой базы данных являются всего две вещи - это таблицы и 4 типа запросов. Именно с них и началось. Все эти сложности, которые описываются тысячами веб-сайтов в Интернете, появились уже после них и применяются к этим азам.
Первым делом, рассмотрим что такое таблица . Хоть раз, но каждый открывал эксельный файл или электронную таблицу OpenOffice (см. обзор офисных пакетов). Так вот это, по сути, и есть база данных. У вас есть колонки и строки, в пересечении которых вы заполняете данные (числа, текст, даты и прочее).
Однако, тут есть важный момент - если эксель позволяет произвольно вставлять данные в любую ячейку, то существующие базы данных имеют некоторые ограничения.
1. Каждая колонка имеет уникальное некое имя (аналогично A, B, C).
2. В каждой колонке могут располагаться данные только одного типа. К примеру, в любой ячейке колонки B только числа, в колонке C только текст, в колонке F только даты.
3. Количество колонок фиксировано и исчислимо. Простыми словами, в экселе вы можете в любой момент вставить некие данные в ячейку рядом с определенными колонками. В базах данных же, подобное требует, что бы вы сначала добавили колонку с именем и определили ее тип, а только лишь потом редактировали данные.
4. Единицей измерения таблицы принято считать не отдельную ячейку, а каждую строку. К примеру, если у вас в таблице три колонки "Имя (Name) / День рождения (Date) / Возраст (Age)", то единицей измерения считается "Вася / 12.12.2012 / 7", а не какое-либо отдельное значение. Конечно, редактировать или просматривать отдельные ячейки этой строки можно, но добавлять данные в таблицу можно только построчно.
5. Существует специальное значение NULL, которое обозначает отсутствие данных в ячейке. Понять суть можно из следующего момента - далеко не у всех типов данных можно установить такое значение, которое можно было бы считать отсутствием данных. К примеру, для текста отсутствие данных можно как-то сравнить с пустой строкой (хотя и это не всегда корректно), а вот для чисел такого значения просто не существует (0 это число; к примеру, "осталось 0 яблок"). Поэтому и было введено специальное значение NULL.
Пример таблицы somedata:
Рассмотрим основные 4 типа запросов . Не сложно догадаться, что подобную таблицу хотелось бы каким-то образом составлять под конкретные задачи, а так же получать отфильтрованные данные. Просто представьте, что в таблице выше не 3 строки, а целых 10 000. Найти что-либо или подкорректировать будет весьма проблематично. Именно поэтому и были введены следующие 4 типа запросов:
1. Вставка (insert) - позволяет вставлять в таблицу единицы измерения, то есть строки.
2. Удаление (delete) - позволяет удалять из таблицы строки данных.
3. Обновление (update) - позволяет изменять отдельные ячейки строк.
4. Выборка (select) - позволяет из данных таблицы получать произвольного вида подтаблицы с необходимыми результатами, которые так же называют выборками.
Рассмотрим все типы более подробно.
Но, перед этим, хотелось бы отметить, что будет использован синтаксис для базы данных MySQL. Однако, для азов это не так критично, так как приведенные примеры если и будут отличаться в разных базах данных, то весьма незначительно.
Запрос вставки (insert)
Запрос вставки строится следующим образом:
insert into table (col1, col2, ..., colN) values (val11, val12, ..., val1N), (val21, val22, ..., val2N), ..., (valM1, valM2, ..., valMN);
где insert into - это начало запроса, table (col1, col2, ..., colN) - это названия колонок в нужном порядке (сделано для удобства), values - указывает, что далее будут указаны строки для вставки, (val11, val12, ..., val1N), (val21, val22, ..., val2N), ..., (valM1, valM2, ..., valMN) - это конкретные значения для вставки (в соответствующем порядке с колонками). Важно, что после каждого sql-запроса необходимо ставить точку с запятой. Это позволяет отделять одни запросы от других.
К примеру, если бы потребовалось добавить две строки в таблицу из примера somedate, то sql-запрос выглядел бы так:
insert into somedata (Name, Age, Date) values ("Коля", 10, "04.05.2009"), ("Анастасия", 22, "12.02.1997");
Это строчки появились бы в конце таблицы. Конечно, в реальных базах данных, размещение строчек может сильно зависеть от применяемых механизмов, однако по умолчанию это так.
Запрос для удаления данных (delete)
SQL-запрос для удаления данных строится следующим образом:
где delete from - это начало запроса, table - это конкретное название таблицы, where - указывает, что далее будут указаны фильтры строк, которые необходимо удалить, clause - это сами фильтры для выборки строк. После sql-запроса ставится точка с запятой.
Важно отметить, что фильтр может быть весьма сложным и состоять из большого количества условий. Для его составления используются три операнда - and (И) , or (ИЛИ) и скобки (для отделения сложных выражений) . Логика здесь аналогична самой простой математики.
Примечание
К примеру, представим, что вам необходимо удалить все строки, где возраст больше 1 и меньше 5, или же строки, в которых указывается имя Масяня. Тогда запрос выглядел бы так:
Если разбирать логику, то этот запрос говорит базе данных, чтобы она проверила каждую строчку таблицы somedate и если строка удовлетворяет условиям, то ее необходимо удалить.
Запрос обновления данных (update)
Запрос обновления данных строится следующим образом:
где update - это начало sql-запроса, table - это конкретное имя таблицы, set - обозначает, что далее будет список требуемых изменений, col1 = val1, col2 = val2, ..., colN = valN - это перечисление через запятую колонок с присваиваемыми им значениями, where - указывает, что далее будут перечислены условия отбора, clause - условие фильтра (аналогично delete). Запрос так же заканчивается точкой с запятой.
Примечание : Важно отметить, что часть where с clause являются необязательными. То есть, если фильтр не требуется, то их можно не писать. Однако, если фильтр нужен, то обе составляющих необходимо использовать в запросе.
К примеру, если необходимо не удалить все строки из примера ранее, а указать для всех этих строк дату рождения 31.12.2222 и возраст -203, то sql-запрос выглядел бы так:
Обратите внимание, что поля Age и Date изменяются только после проверки условий фильтра. Это важно, так как запрос позволяет использовать текущие значения колонок при фильтрации (иначе бы могли возникать несоответствия).
Запрос для выборки данных (select)
Это, пожалуй, один из самых часто используемых типов sql-запросов (ведь данные составляются не для хранения, а для их использования) и поэтому у него имеется масса дополнительных возможностей (сортировка, группировка и так далее; о них читайте в прочих обзорах, в рамках этого обзора они не столь важны).
Строится данный запрос следующим образом:
где select - это начало запроса, col1, col2, ..., colN - это перечисление колонок, которые необходимо отобразить (важно знать, что если требуются все колонки таблицы, то вместо перечисления можно указывать просто символ звездочки * , что очень удобно, особенно, если структура таблицы постоянно корректируется или же заранее не известны все доступные колонки, кроме тех, что в фильтре), from - обозначает, что далее будет указано имя таблицы, where - обозначает, что далее будет указан фильтр, clause - сам фильтр (аналогично delete и update). После sql-запроса ставится точка с запятой.
Примечание : Важно отметить, что часть where с clause являются необязательными. То есть, если фильтр не требуется, то их можно не писать. Однако, если фильтр нужен, то обе составляющих необходимо использовать в запросе.
Рассмотрим пример. Допустим, нам необходимо получить возраст и имя всех тех, чье день рождение было до 1-го января 1999 года. Тогда sql-запрос будет выглядеть так:
Обратите внимание, что порядок колонок после select может быть произвольным, что позволяет получать удобные для восприятия подтаблицы данных (выборки).
Послесловие
Стоит знать, что каждая из баз данных позволяет использовать рассмотренные sql-запросы с расширенными возможностями. К примеру, одновременное удаление из нескольких таблиц или же вставка строк с использованием запросов выборки. Поэтому, если у вас возникает необходимость в чем-то специфическом, то стоит более подробно изучать возможности каждой базы данных.

На уроке будет рассмотрен язык запросов sql: основы синтаксиса языка sql, работа в phpMyAdmin и сервисе для онлайн проверки sql запросов
База данных - централизованное хранилище данных, обеспечивающее хранение, доступ, первичную обработку и поиск информации.
Базы данных разделяются на:
- Иерархические
- Сетевые
- Реляционные
- Объектно-ориентированные
SQL (Structured Query Language) — представляет из себя структурированный язык запросов (перевод с английского). Язык ориентирован на работу с реляционными (табличными) базами данных. Язык прост и, по сути, состоит из команд (интерпретируемый), посредством которых можно работать с большими массивами данных (базами данных), удаляя, добавляя, изменяя информацию в них и осуществляя удобный поиск.
Для работы с SQL кодом необходима система управления базами данных (СУБД), которая предоставляет функционал для работы с базами данных.
Система управления базами данных (СУБД) - совокупность языковых и программных средств, предназначенных для создания, ведения и совместного использования БД многими пользователями.
Обычно, для обучения используется СУБД Microsoft Access , но мы будем использовать более распространенную в веб сфере систему — . Для удобства будет использовать веб-интерфейс или онлайн сервис для построения sql запросов , принцип работы с которыми описан ниже.
Важно: При работе с реляционными или табличными базами данных строки таблицы будем называть записями , а столбцы — полями .
Каждый столбец должен иметь свой тип данных, т.е. должен быть предназначен для внесения данных определенного типа. описаны в одном из уроков данного курса.
Составляющие языка SQL
Язык SQL состоит из следующих составных частей:
- язык манипулирования данными (Data Manipulation Language, DML);
- язык определения данных (Data Definition Language, DDL);
- язык управления данными (Data Control Language, DCL).
1.
Язык манипулирования данными состоит из 4 главных команд:
- выборка данных из БД —
- вставка данных в таблицу БД —
- обновление (изменение) данных в таблицах БД —
- удаление данных из БД —
Язык определения данных используется для создания и изменения структуры базы данных и ее составных частей — таблиц, индексов, представлений (виртуальных таблиц), а также триггеров и сохраненных процедур.
Мы будем рассматривать лишь несколько из основных команд языка . Ими являются:
- создание базы данных — CREATE DATABASE
- создание таблицы — CREATE TABLE
- изменение таблицы (структуры) — ALTER TABLE
- удаление таблицы — DROP TABLE
Язык управления данными используется для управления правами доступа к данным и выполнением процедур в многопользовательской среде.
Как сделать sql запрос в phpmyadmin
- Запустить ярлык start denwer .
- В адресной строке браузера набрать http://localhost/tools/phpmyadmin .
- В левой части окна выбрать интересующую базу данных или создать ее (если еще не создана). Создание базы данных в phpmyadmin рассмотрено .
- Если известна таблица, с которой будет работать запрос — в левой части окна выбрать эту таблицу.
- Выбрать вкладку SQL и начать вводить запрос.
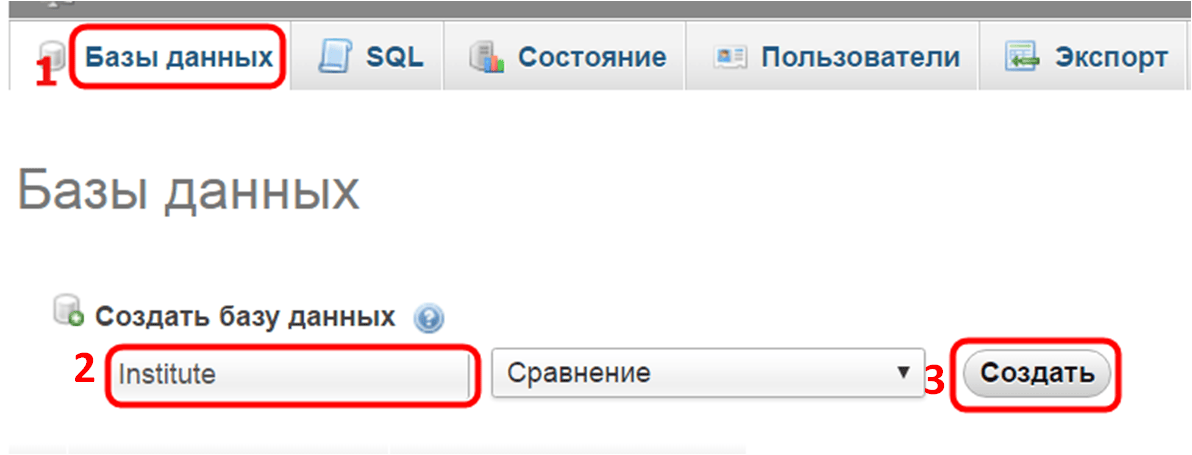
Создание базы данных в phpmyadmin
Для начала необходимо выполнить первые два пункта из .
Затем:
- в открывшемся веб-интерфейсе выбрать вкладку Базы данных ;
- в поле Создать базу данных ввести название базы;
- щелкнуть по кнопке Создать ;
- теперь для продолжения работы в phpMyAdmin в созданной базе данных можно перейти к .
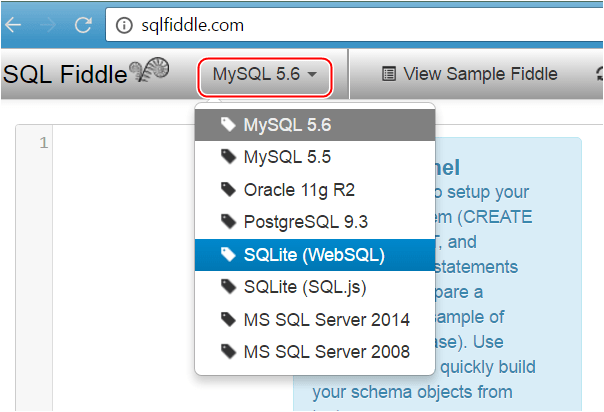
Работа в сервисе sql fiddle
Онлайн проверка sql запросов возможна при помощи сервиса .
Самый простой способ организации работы состоит из следующих этапов:
Еще пример: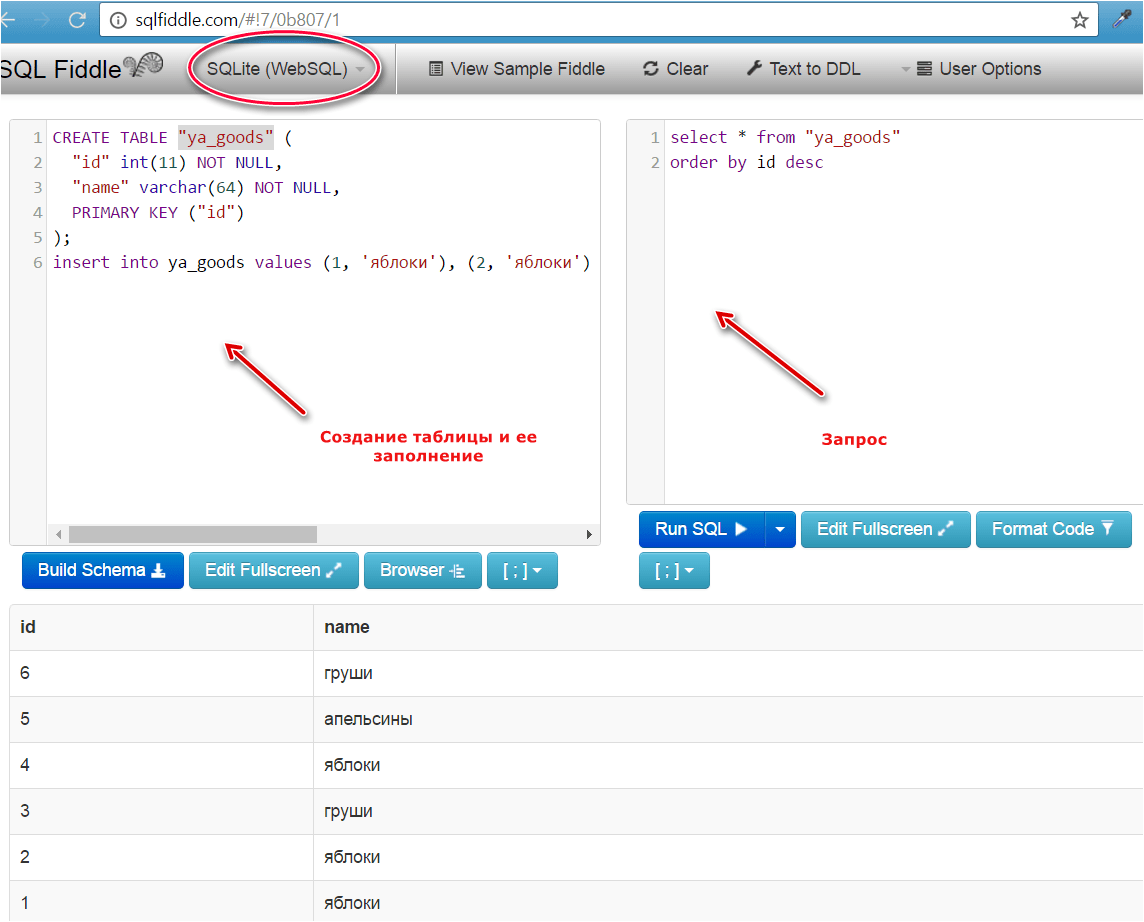
Теперь некоторые пункты рассмотрим подробнее.
Создание таблиц:
Пример: создайте сразу три таблицы (teachers, lessons и courses); добавьте по нескольку значений в каждую таблицу.
* для тех, кто незнаком с синтаксисом — просто скопировать полностью код и вставить в левое окошко сервиса
* урок по созданию таблиц в языке SQL
| /*teachers*/ CREATE TABLE `teachers` ( `id` INT (11 ) NOT NULL , `name` VARCHAR (25 ) NOT NULL , `code` INT (11 ) , `zarplata` INT (11 ) , `premia` INT (11 ) , PRIMARY KEY (`id` ) ) ; INSERT INTO teachers VALUES (1 , "Иванов" , 1 , 10000 , 500 ) , (2 , "Петров" , 1 , 15000 , 1000 ) , (3 , "Сидоров" , 1 , 14000 , 800 ) , (4 , "Боброва" , 1 , 11000 , 800 ) ; /*lessons*/ CREATE TABLE `lessons` ( `id` INT (11 ) NOT NULL , `tid` INT (11 ) , `course` VARCHAR (25 ) , `date` VARCHAR (25 ) , PRIMARY KEY (`id` ) ) ; INSERT INTO lessons VALUES (1 , 1 , "php" , "2015-05-04" ) , (2 , 1 , "xml" , "2016-13-12" ) ; /*courses*/ CREATE TABLE `courses` ( `id` INT (11 ) NOT NULL , `tid` INT (11 ) , `title` VARCHAR (25 ) , `length` INT (11 ) , PRIMARY KEY (`id` ) ) ; INSERT INTO courses VALUES (1 , 1 , "php" , 54 ) , (2 , 1 , "xml" , 72 ) , (3 , 2 , "sql" , 25 ) ; |
/*teachers*/ CREATE TABLE `teachers` (`id` int(11) NOT NULL, `name` varchar(25) NOT NULL, `code` int(11), `zarplata` int(11), `premia` int(11), PRIMARY KEY (`id`)); insert into teachers values (1, "Иванов",1,10000,500), (2, "Петров",1,15000,1000) ,(3, "Сидоров",1,14000,800), (4,"Боброва",1,11000,800); /*lessons*/ CREATE TABLE `lessons` (`id` int(11) NOT NULL, `tid` int(11), `course` varchar(25), `date` varchar(25), PRIMARY KEY (`id`)); insert into lessons values (1,1, "php","2015-05-04"), (2,1, "xml","2016-13-12"); /*courses*/ CREATE TABLE `courses` (`id` int(11) NOT NULL, `tid` int(11), `title` varchar(25), `length` int(11), PRIMARY KEY (`id`)); insert into courses values (1,1, "php",54), (2,1, "xml",72), (3,2, "sql",25);
В результате получим таблицы с данными:
Отправка запроса:
Для того чтобы протестировать работоспособность сервиса, добавьте в правое окошко код запроса.
Пример: при помощи запроса выберите все данные из таблицы teachers, касаемые учителя с фамилией Иванов
На дальнейших уроках SQL будет использоваться та же схема, поэтому необходимо будет просто копировать схему и вставлять в левое окно сервиса.
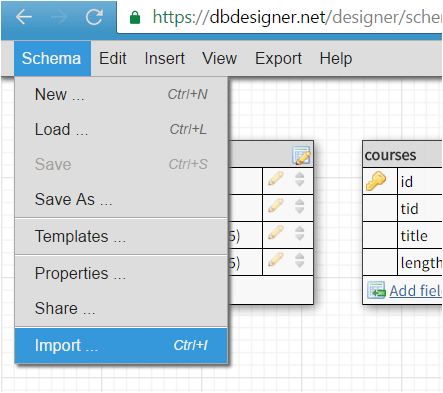
Для онлайн визуализации схемы базы данных можно воспользоваться сервисом https://dbdesigner.net/ :
- Создать свой аккаунт (войти в него, если уже есть).
- Щелкнуть по кнопке Go to Application .
- Меню Schema -> Import .
- Скопировать и вставить в появившееся окно код создания и заполнения таблиц базы данных
Вы новичок в программировании или же просто раньше избегали изучения SQL? Тогда вы попали по нужному адресу, так как любой разработчик в конце-концов сталкивается с необходимостью знать этот язык запросов. Пусть вы и не будете главным дизайнером баз данных, но работы с ними избежать практически невозможно. Я надеюсь этот краткий обзор синтаксиса основных SQL-запросов поможет заинтересованному разработчику и любому, кому это понадобится.
Что такое база данных SQL?
Структурированный язык запросов (Structured Query Language) – стандарт коммуникации с базой данных, который поддержан ANSI. Самая последняя версия – SQL-99, хотя новый стандарт SQL-200n уже находится в разработке. Большинство баз данных твердо придерживается стандарта ANSI-92. Было много обсуждений по поводу введения более современных стандартов, но изготовители коммерческих баз данных отклоняются от этого, развивая свои новые концепции манипуляции хранимыми данными. Почти каждая отдельная база данных использует некоторый уникальный набор синтаксиса, хоть и очень сильно подобного стандарту ANSI. В большинстве случаев, этот синтаксис является расширением базового стандарта, хотя бывают случаи, когда такой синтаксис приводит к различным результатам для разных баз данных. Всегда неплохой идеей будет просмотр документации к базе данных, особенно, если получаются неожиданные результаты.
Если вы впервые встречаетесь с SQL, то необходимо ознакомиться с основными концепциями, которые нужно понять.
В общих терминах, «SQL база данных» является общим названием для реляционной системы управления базами данных (РСУБД). Для некоторых систем, «база данных» также относится к группе таблиц, данных, конфигурационной информации, которые являются неотъемлемо отдельной частью от других, подобных конструкций. В этом случае, каждая инсталляция SQL базы данных может состоять из нескольких баз данных. В других системах, они упомянуты как таблицы.
Таблица – конструкция базы данных, которая состоит из столбцов, содержащих строки данных. Обычно таблицы созданы для того, чтобы содержать связанную информацию. В пределах той же самой базы данных могут быть созданы несколько таблиц.
Каждый столбец представляет собой атрибут или совокупность атрибутов объектов, например идентификационные номера служащих, рост, цвет машин и т.п. Часто в отношении столбца используется термин поле с указанием имени, например «в поле Name». Поле строки является минимальным элементом таблицы. Каждый столбец в таблице имеет определенное имя, тип данных и размер. Имена столбцов должны быть уникальны в пределах таблицы.
Каждая строка (или запись) представляет собой совокупность атрибутов конкретного объекта, например, в строке может содержаться идентификационный номер служащего, размер его зарплаты, год его рождения и т.д. Строки таблиц не имеют названий. Чтобы обратиться к конкретной строке, пользователю необходимо указать какой-то атрибут (или набор атрибутов), уникально ее идентифицирующий.
Одной из важнейших операций, которые выполняются при работе с данными, является выборка хранящейся в базе данных информации. Для этого пользователь должен выполнить запрос (query).
Теперь давайте рассмотрим основные типы запросов к базе данных, которые сосредоточены на манипуляции данными в пределах базы. Для наших целей, все примеры приведены в стандартном SQL, дабы соответствовать любой среде.
Типы запросов данных
Есть четыре основных типа запросов данных в SQL, которые относятся к так называемому языку манипулирования данными (Data Manipulation Language или DML):
SELECT
– выбрать строки из таблиц;
INSERT
– добавить строки в таблицу;
UPDATE
– изменить строки в таблице;
DELETE
– удалить строки в таблице;
Каждый из этих запросов имеет различные операторы и функции, которые используются для того, чтобы произвести какие-то действия с данными. Запрос SELECT имеет самое большое количество опций. Существуют также дополнительные типы запросов, используемых вместе с SELECT, типа JOIN и UNION. Но пока, мы сосредоточимся только на основных запросах.
Использование запроса SELECT для выборки нужных данных
Чтобы получить информацию, хранящуюся в базе данных используется запрос SELECT. Базовое действие этого запроса ограничено одной таблицей, хотя существуют конструкции, обеспечивающие выборку с нескольких таблиц одновременно. Для того, чтобы получить все строки данных для специфических столбцов, используется запрос такого вида:
SELECT column1, column2 FROM table_name;
Также, можно получить все столбцы из таблицы, используя подстановочный знак «*»:
SELECT * FROM table_name;
Это может быть полезно в том случае, когда вы собираетесь выбрать данные с определенным условием WHERE. Следующий запрос возвратит все столбцы со всех строк, где «column1» содержит значение «3»:
SELECT * FROM table_name WHERE column1=3;
Кроме «=» (равно), существуют следующие условные операторы:
Условные операторы:
= Равно
<>
Не равно
>
Больше
<
Меньше
>=
Больше или равно
<=
Меньше или равно
Дополнительно можно использовать условия BITWEEN и LIKE для сравнения с условием WHERE, а так же комбинации операторов AND и OR.
SELECT * FROM table_name WHERE ((Age >= 18) AND (LastName BETWEEN ‘Иванов’ AND ‘Сидоров’)) OR Company LIKE ‘%Motorola%’;
Что в переводе на русский язык означает: выбрать все столбцы из таблицы table_name, где значение столбца age больше или равно 18, а также значение столбца LastName находится в алфавитном промежутке от Иванов до Сидоров включительно, или же значением столбца Company является Motorola.
Использование запроса INSERT для вставки новых данных
Запрос INSERT используется для создания новой строки данных. Для обновления уже существующих данных или пустых полей строки нужно использовать запрос UPDATE.
Примерный синтаксис запроса INSERT:
INSERT INTO table_name (column1, column2, column3) VALUES (‘data1’, ‘data2’, ‘data3’);
Если вы собираетесь вставлять все значения в порядке, в котором находятся столбцы таблицы, то можно и не указывать имена столбцов, хотя для удобочитаемости это предпочтительнее. Кроме того, если вы перечисляете столбцы, необязательно указывать их по порядку нахождения в базе данных, пока значения, которые вы вводите, соответсвуют этому порядку. Вы не должны перечислять столбцы, в которые не вводится информация.
Изменяется уже существующая информация в базе данных очень похожим образом.
Запрос UPDATE и условие WHERE
UPDATE используется для того, чтобы изменить существующие значения или освободить поле в строке, поэтому новые значения должны соответствовать существующему типу данных и обеспечивать приемлемые значения. Если вы не хотите изменить значения во всех строках, то нужно использовать условие WHERE.
UPDATE table_name SET column1 = ‘data1’, column2 = ‘data2’ WHERE column3 = ‘data3’;
Вы можете использовать WHERE для любого столбца, включая тот, который хотите изменить. Это используется когда необходимо заменить одно определенное значение на другое.
UPDATE table_name SET FirstName = ‘Василий’ WHERE FirstName = ‘Василий’ AND LastName = ‘Пупкин’;
Будьте осторожны! Запрос DELETE удаляет целые строки
Запрос DELETE полность удаляет строку из базы данных. Если вы хотите удалить одно единственное поле, то нужно использовать запрос UPDATE и установить для этого поля значение, которое будет являться аналогом NULL в вашей программе. Будьте внимательны, и ограничивайте ваш запрос DELETE условием WHERE, иначе вы можете потерять все содержимое таблицы.
DELETE FROM table_name WHERE column1 = ‘data1’;
Как только строка была удалена из вашей базы данных, она не подлежит восстановлению, поэтому желательно иметь столбец по имени «IsActive», или что-то типа того, который вы можете изменить на ноль, что будет указывать на блокировку представления данных из этой строки.
Теперь вы знаете основы SQL запросов
SQL – язык баз данных, и мы рассмотрели наиболее важные и базовые команды, используемые в запросах данных. Множество основных концепций не были затронуты (SUM и COUNT например), но те немногие команды, которые удалось перечислить выше, должны побудить вас к активным действиям и более глубокому изучению замечательного языка запросов под именем SQL.